APMは強力な可視化ツールですが、すべてのトレースを記録し続けるとデータ量とコストが膨らみます。「検証段階ではよかったが、本番のトラフィック量で全データを送ったらコストが跳ね上がりそう」「ヘルスチェックのような価値の低いトレースまで記録されていて、ノイズが多い」と感じることもあるでしょう。コスト・データ量の見極めでコスト感を掴んだ方なら、こうした懸念を感じているかもしれません。
しかし、むやみにデータを削ればよいわけではありません。エラーが発生したトレースやスロークエリのトレースは、障害対応やパフォーマンス改善に不可欠です。「削りたいけれども、重要なデータを失いたくない」という葛藤は誰もが抱えるものです。
この章では、フィルタリングとサンプリングという2つのアプローチで、価値の低いデータだけを選択的に削り、重要なトレースは確実に残す方法を解説します。Mackerel OpenTelemetryコレクターの設定で実現でき、Mackerel OpenTelemetryコレクターによる送信設定の知識が前提になります。
- なぜデータを絞る必要があるのか
- フィルタリングとサンプリング ― 2つのアプローチ
- サンプリングの2つの方式 ― ヘッドベースとテイルベース
- テイルベースサンプリング
- どちらを選ぶか
- サンプリングと統計のバイアス
- 「残すべきデータ」と「削ってよいデータ」の判断基準
- 実践 ― コレクターでフィルタリングとサンプリングを設定する
- 最適化の効果を確認する
- 次のステップへ
なぜデータを絞る必要があるのか
データ量がコストに直結する
コスト・データ量の見極めで解説したとおり、Mackerel APMのコストはスパン数に比例します。本番環境のトラフィック量では、全トレースを記録するとコストが想定以上に膨らむケースがあります。
すべてのトレースが等しく重要なわけではない
送信されるトレースの中には、パフォーマンス分析の観点で価値が低いものが含まれています。
- ヘルスチェックやロードバランサーの死活監視リクエストは大量に発生しますが、分析に使うことはほとんどありません
- 正常に処理されたリクエストの大半は似た内容であり、全数を保持する必要はないことが多いです
- 一方で、エラーが発生したリクエストや処理時間が異常に長いリクエストは、少数でも確実に残したいデータです
計装レベルでの制御もある
フィルタリングやサンプリングはコレクター側でデータを絞る方法ですが、そもそもアプリケーション側で生成されるスパンを減らすアプローチもあります。多くの言語では、環境変数を使ってライブラリ単位で計装の有効・無効を切り替えられます。不要なライブラリの計装を無効にすることで、スパン数の削減だけでなくアプリケーション自体のパフォーマンス向上にもつながります。具体的な設定方法は各言語のセットアップガイドの「自動計装の対象」を参照してください。
ノイズの削減は分析品質の向上にもつながる
不要なデータが多いと、本当に注目すべきトレースが埋もれてしまいます。データを絞ることで、Mackerel APMのダッシュボードやトレース一覧が見やすくなり、問題の発見が早くなるという効果もあります。
フィルタリングとサンプリング ― 2つのアプローチ
データを絞る方法には、フィルタリングとサンプリングの2つがあります。

フィルタリングとは
フィルタリングは、特定の条件に合致するスパンを除外する手法です。ヘルスチェックや静的ファイル配信のように単一スパンで構成されるリクエストであれば、実質的にトレースごと除外されます。
- 例:URLが
/healthzのスパンをすべて除外する - 例:静的ファイル配信のスパンを除外する
メールの「迷惑メールフィルター」に似ています。不要なものを条件で振り分けて捨てるイメージです。
なお、フィルタリングはスパン単位で動作するため、複数のスパンで構成されるトレースでは、条件に合致したスパンだけが除外され、残りのスパンはそのまま送信されます。トレース全体を条件付きで残す・捨てるという制御には、後述のテイルベースサンプリングが適しています。
- メリット:ルールが明確で、何が削られるかが予測しやすい
- デメリット:条件に合致しないデータはすべて残るため、トラフィック量自体が多い場合のデータ削減幅は限定的
サンプリングとは
サンプリングは、トレースを一定の割合で「間引き」する手法です。
- 例:全トレースの10%だけを記録し、残り90%は破棄する
- 例:エラーが発生したトレースは100%残し、正常なトレースは5%だけ残す
世論調査のように、全数ではなくサンプルから全体の傾向を推測するアプローチです。
- メリット:データ量を大幅に削減でき、コスト管理がしやすい
- デメリット:間引かれたトレースは二度と復元できない。設定次第では重要なトレースを見逃すリスクがある。また、条件付きで残す割合を変えると、REDメトリックやHTTPサーバータブの統計にバイアスがかかる点にも注意が必要(詳しくは後述)
フィルタリングとサンプリングの使い分け
両方を組み合わせるのが一般的です。
- まずはフィルタリングで「明らかに不要なデータ」を除外する
- それでもデータ量が多い場合に、サンプリングで全体量を絞る
コレクターのパイプラインでも、フィルタリング → サンプリングの順に組み込むのが自然な構成です。
サンプリングの2つの方式 ― ヘッドベースとテイルベース
サンプリングには、判定のタイミングが異なる2つの方式があります。
ヘッドベースサンプリング
ヘッドベースサンプリングは、トレースの開始時点で記録するかどうかを決定する方式です。
リクエストが到着した瞬間に乱数で判定し、記録対象外と判定されたトレースはスパンを生成しません。判定がシンプルなため実装が容易で、スパン生成自体を抑制するためアプリケーションの処理負荷も軽減されます。
ただし、トレースの内容(エラーの有無、処理時間)がわかる前に判定するため、「エラートレースだけ残す」といった条件付きの制御はできません。
設定方法は2つあります。
方法1:Mackerel OpenTelemetryコレクターの環境変数で設定する
OTELCOL_MACKEREL_SAMPLING_PERCENTAGE=10
設定ファイルを書かずにコレクター側で確率的サンプリングを適用できます。手軽に始めたい場合におすすめです。
方法2:アプリケーション側の環境変数で設定する
OTEL_TRACES_SAMPLER=parentbased_traceidratio
OTEL_TRACES_SAMPLER_ARG=0.1
アプリケーション側でスパン生成自体を抑制するため、処理負荷の軽減効果も得られます。
いずれの方法でも「全トレースの10%のみが記録される」という効果は同じです。
テイルベースサンプリング
テイルベースサンプリングは、トレースが完了した後にその内容を見て記録するかどうかを決定する方式です。
コレクターがトレースの全スパンを一時的にバッファに保持し、トレースが完了した時点で条件を評価して残すかどうかを判断します。コレクターの tail_sampling プロセッサーで設定します。
トレースの内容に基づいた柔軟な条件設定が可能で、「エラートレースは100%残す」「処理時間が1秒を超えたトレースは残す」といったルールが書けます。ただし、コレクターにメモリとCPUの追加負荷がかかるため、バッファの設定には注意が必要です。
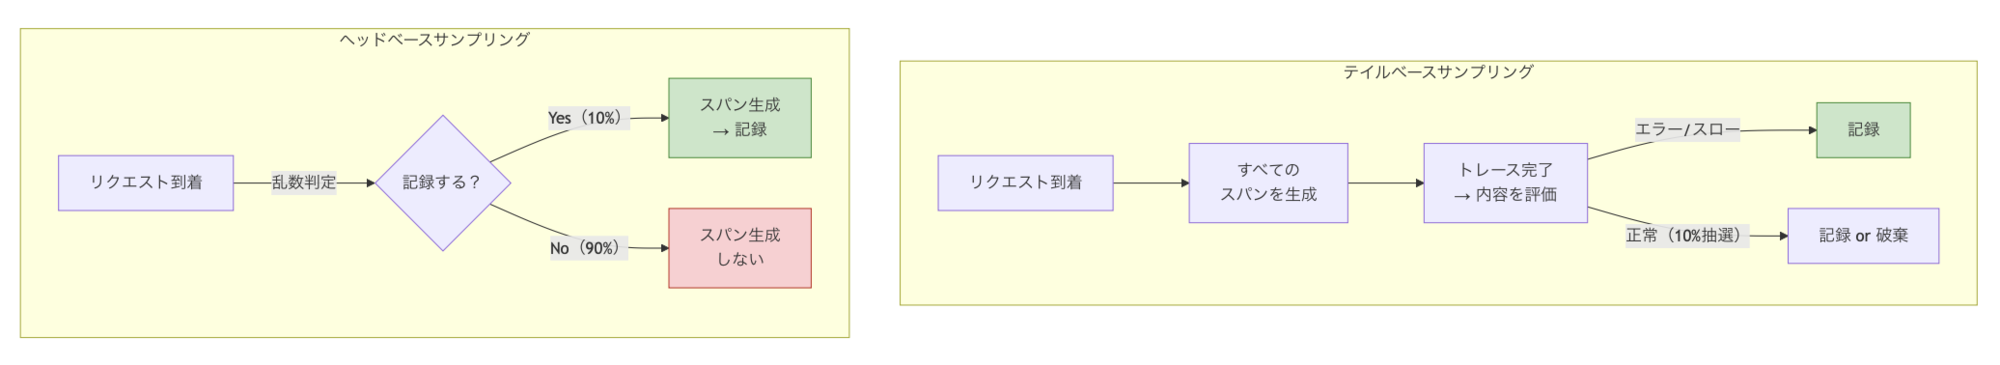
どちらを選ぶか
- 手軽に始めたいならヘッドベース:環境変数を1つ追加するだけで設定できます
- 重要なトレースを確実に残したいならテイルベース:設定は複雑になりますが、コスト最適化と可観測性の両立が可能です
- 両方を組み合わせることもできます(ヘッドベースで大まかに絞り、テイルベースで条件付きの制御を追加)
サンプリングと統計のバイアス
サンプリング方式の選択は、Mackerel APMの画面に表示される統計にも影響します。
ヘッドベースサンプリングは、トレースの内容に関係なくランダムに間引くため、サンプリング後のデータでもリクエストの傾向(エラー率の比率、レイテンシーの分布など)はおおむね実態を反映します。
一方、テイルベースサンプリングで「エラートレースは100%残し、正常トレースは10%に絞る」といった条件付きの設定をすると、Mackerel APMに届くデータに偏りが生じます。
- リクエスト数:正常トレースが間引かれるため、実際のトラフィックより少なく表示されます
- エラー率:エラートレースは全数残る一方で正常トレースは10%しか残らないため、実際よりも高いエラー率が表示されます
- レイテンシー分布:処理時間が長いトレースを優先的に残す設定では、レイテンシーの分布が遅い方に偏ります
REDメトリックのサマリータブやHTTPサーバータブのエンドポイント別統計も、サンプリング後のデータに基づいて集計されるため、同様のバイアスがかかります。
テイルベースサンプリングを導入する際は、「統計の正確さ」と「重要なトレースの確実な保持」がトレードオフの関係にあることを意識してください。統計の正確さを重視する場合はヘッドベースサンプリングを選択し、障害対応やパフォーマンス分析を重視する場合はテイルベースサンプリングを選択する、という判断になります。
「残すべきデータ」と「削ってよいデータ」の判断基準
削ってよいデータの例
- ヘルスチェック・死活監視:
/healthz、/readyz、/pingなどのエンドポイントへのリクエスト。大量に発生しますが分析価値は低いケースがほとんどです - 静的ファイルの配信:CSS、JavaScript、画像ファイルなどの配信。パフォーマンス分析の対象外となることが多いリクエストです
- 正常リクエストの大部分:正常に処理されたリクエストは全数保持する必要がないことが多く、サンプリングで一部を残せば傾向把握には十分です
確実に残すべきデータの例
- エラーが発生したトレース:ステータスコード5xx、例外がスローされたリクエスト。障害分析に不可欠です
- 処理時間が長いトレース:SLOを超過したリクエスト。パフォーマンス改善の手がかりになります
- 特定のエンドポイント:決済処理、認証フローなど、ビジネス上重要な処理のトレース
判断に迷ったら
最初から完璧を目指す必要はありません。まずはヘルスチェックの除外など、明らかなものから始めてください。運用しながら「このトレースは実際に見ているか?」を振り返り、段階的に調整していくのがおすすめです。
実践 ― コレクターでフィルタリングとサンプリングを設定する
Mackerel OpenTelemetryコレクターには filter、tail_sampling、probabilistic_sampler プロセッサーがすべて組み込み済みのため、追加のインストールは不要です。カスタム設定ファイル(config.yaml)にプロセッサーを追加するだけで利用できます。
ここでは基本的な設定例を示します。詳細な設定パターンやオプションは別章で解説しています。
フィルタリングの設定例
filter プロセッサーを使って、ヘルスチェックのトレースを除外する例です。
processors:
  filter/healthcheck:
    error_mode: ignore
    traces:
      span:
        - 'attributes["http.route"] == "/healthz"'
        - 'attributes["http.route"] == "/readyz"'
この設定により、/healthz と /readyz へのリクエストのスパンがフィルタリングされ、Mackerel APMには送信されません。
traces.span に列挙した条件はOR評価です。いずれかの条件にマッチしたスパンが除外されます。複数の条件をANDで組み合わせたい場合は、1つの条件式の中で and 演算子を使います。
- 'attributes["http.route"] == "/api/internal" and attributes["http.method"] == "GET"'
リソース属性(サービス名など)で絞り込みたい場合は、traces.span の中で resource.attributes["service.name"] のようにパスを指定するか、traces.resource コンテキストを使ってそのリソースに属するスパンをまとめて除外できます。
パイプラインへの組み込みは以下のようになります。
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, filter/healthcheck]
      exporters: [mackerel_otlp]
テイルベースサンプリングの設定例
tail_sampling プロセッサーを使った基本的な設定例です。
processors:
  tail_sampling:
    decision_wait: 10s
    num_traces: 100000
    policies:
      - name: errors-policy
        type: status_code
        status_code:
          status_codes:
            - ERROR
      - name: slow-traces-policy
        type: latency
        latency:
          threshold_ms: 1000
      - name: normal-sampling
        type: probabilistic
        probabilistic:
          sampling_percentage: 10
この設定が意味すること:
- errors-policy:エラーステータスのトレースは全数残す
- slow-traces-policy:処理時間が1秒を超えたトレースも全数残す
- normal-sampling:上記に該当しないトレースは10%だけ残す
複数のポリシーはOR評価で、いずれかのポリシーが「残す」と判定すればトレースは記録されます。この例では、エラーまたは遅延のトレースは常に残り、それ以外は10%の確率で残ります。
「エラーかつ遅延の両方を満たすトレースだけ残す」のようにAND評価にしたい場合は、and タイプのポリシーでサブポリシーを束ねます。
- name: slow-errors
  type: and
  and:
    and_sub_policy:
      - name: errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: slow
        type: latency
        latency:
          threshold_ms: 1000
decision_wait はトレースの完了を待つ時間、num_traces はバッファに保持するトレースの最大数です。
フィルタリングとサンプリングを組み合わせた構成
両方を組み合わせたパイプライン構成の全体像です。
receivers:
  otlp:
    protocols:
      grpc:
      http:

processors:
  memory_limiter:
    check_interval: 1s
    limit_mib: 512
  filter/healthcheck:
    error_mode: ignore
    traces:
      span:
        - 'attributes["http.route"] == "/healthz"'
        - 'attributes["http.route"] == "/readyz"'
  tail_sampling:
    decision_wait: 10s
    num_traces: 100000
    policies:
      - name: errors-policy
        type: status_code
        status_code:
          status_codes:
            - ERROR
      - name: slow-traces-policy
        type: latency
        latency:
          threshold_ms: 1000
      - name: normal-sampling
        type: probabilistic
        probabilistic:
          sampling_percentage: 10

exporters:
  mackerel_otlp:

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, filter/healthcheck, tail_sampling]
      exporters: [mackerel_otlp]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter]
      exporters: [mackerel_otlp]
プロセッサーの順序は memory_limiter → filter → tail_sampling です。まずメモリ制限をチェックし、次にフィルタリングで不要データを除外、その後にサンプリングで残りのデータを間引きます。バッチ送信はエクスポーターの sending_queue.batch で処理されます。

設定変更後の確認
設定を変更したら、以下の手順で正しく動作しているか確認してください。
otelcol-mackerel --config config.yaml validateでバリデーションを実行する- コレクターを再起動し、ログにエラーが出ていないことを確認する
- Mackerel APMの画面でスパン数の変化を確認する
- 意図したトレースが残り、不要なトレース(ヘルスチェックなど)が除外されていることを確認する
最適化の効果を確認する
データ量の変化を確認する
フィルタリング・サンプリング導入前後で、スパン数がどのくらい減ったかを比較してみましょう。Mackerel APMの利用量画面で確認できます。
コスト削減効果を算出する
削減後のスパン数をもとに、月間コストを再計算します。コスト・データ量の見極めで算出した最適化前のコスト見積もりと比較してみてください。
可観測性への影響を確認する
コスト削減と同時に、可観測性が損なわれていないかも確認しましょう。
- 重要なトレース(エラー、スロークエリ)は引き続き確認できているか
- 過度にサンプリングしすぎて、傾向分析に必要なデータが不足していないか
- 不足を感じたらサンプリングレートを上げるなど、段階的に調整してください
「コスト」と「可観測性」はトレードオフの関係にあります。完璧を目指すより、まずは運用しながら最適なバランスを見つけていくアプローチがおすすめです。
次のステップへ
ここまでの手順で、以下のことが達成できました。
- フィルタリングとサンプリングの概念と使い分けを理解した
- コレクターの設定で不要なデータを除外し、重要なトレースを確実に残す構成を実現した
- データ量の削減効果とコスト最適化の結果を確認した
この一連のガイドを通じて、APMの基礎理解からゼロコード計装によるデータ取得、コレクター経由の安定した送信構成、可視化データの分析、コストの見積もり、そしてフィルタリング・サンプリングによるコスト最適化まで、検証から本番導入への道筋が整いました。本番導入に向けた準備状況を確認したい方は、Mackerel APM 本番導入チェックリストも活用してください。
まだ検証を始めていない方は、ゼロコード計装による最短データ取得から始めてみてください。
- 前の記事:コスト・データ量の見極め
- 次の記事:Mackerel APM 本番導入チェックリスト
